// GAMESTAR — GAMING
Claude Opus 5.5 - Die große Neuerung ist nicht nur, was das Modell kann – sondern was es nicht mehr tun darf
 Claude Opus 5.5 bringt mehr Leistung, höhere Geschwindigkeit und spürbar niedrigere Kosten im Vergleich zu Opus 5. Gleichzeitig schränkt Anthropic den Zugriff auf heikle Fähigkeiten in Cybersicherheit und Biologie gezielt ein. | Bild Anthropic
Je leistungsfähiger große Modelle künstlicher Intelligenz werden, desto schwerer fällt es, Fortschritt allein daran zu messen, welche neuen Aufgaben sie bewältigen. Zunehmend zählt auch, welche Fähigkeiten klare Grenzen erfordern, wer Zugriff darauf erhält und unter welchen Bedingungen. Anthropic stellt genau diese Diskussion seit geraumer Zeit in den Mittelpunkt seiner Sicherheitsstrategie – und zeigt nun besonders deutlich, wohin die Reise gehen soll.
Bei der Weiterentwicklung von Claude geht es längst nicht mehr bloß um Spitzenwerte in Benchmarks, sondern darum, präzise zu steuern, wann bestimmte Fähigkeiten überhaupt bei euch im Alltag ankommen.
Dieser Ansatz spiegelt sich jetzt in Claude Opus 5.5 wider, das von Anthropic als erstes Modell der neuen 5.5-Generation vorgestellt wurde.
Das Unternehmen verspricht bei vielen Aufgaben eine Leistung auf dem Niveau von Fable 5.1, benötigt dafür jedoch spürbar weniger Ressourcen als Opus 5: Bei typischen Arbeitslasten sollen die Kosten um 40 Prozent sinken, während die Textausgabe über 30 Prozent schneller erfolgt. Es ist zudem die erste Veröffentlichung, seitdem Dario Amodei öffentlich gefordert hatte, das Entwicklungstempo der Modelle eng an robuste Sicherheitsmaßnahmen zu koppeln. Genau dieser Gedanke fließt nun direkt in das fertige Produkt ein.
Hinweis: Dieser Artikel stammt im Original von unserer spanischen Schwesterseite Xataka und erscheint bei GameStar Tech in übersetzter und angepasster Form.
Blickt ihr darauf, wo die Verbesserungen liegen, hebt Anthropic vor allem drei Bereiche hervor: agentische Programmierung, Computerbedienung und Wissensarbeit. In internen Tests führt Opus 5.5 mehrere dieser Benchmarks an, wenngleich das Unternehmen selbst zur Zurückhaltung mahnt: Auf diesem Leistungsniveau sagen minimale Punktunterschiede immer weniger darüber aus, was ihr in der Praxis tatsächlich bemerkt. Daher dreht sich die Argumentation nicht mehr vorrangig darum, wer den höchsten Score erzielt, sondern wie viel Arbeit das Modell im Verhältnis zu den anfallenden Kosten erledigen kann.
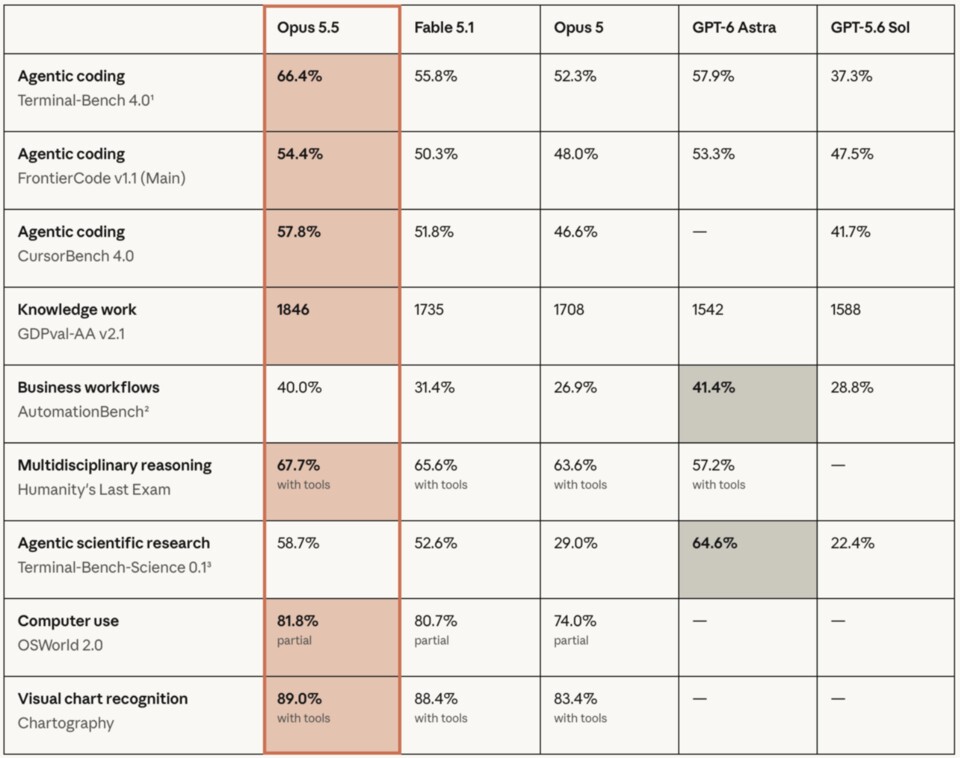 So schneidet Claude Opus 5.5 im Vergleich zu Fable 5.1, Opus 5 und den Modellen von OpenAI in verschiedenen Benchmarks ab | Bild: Anthropic
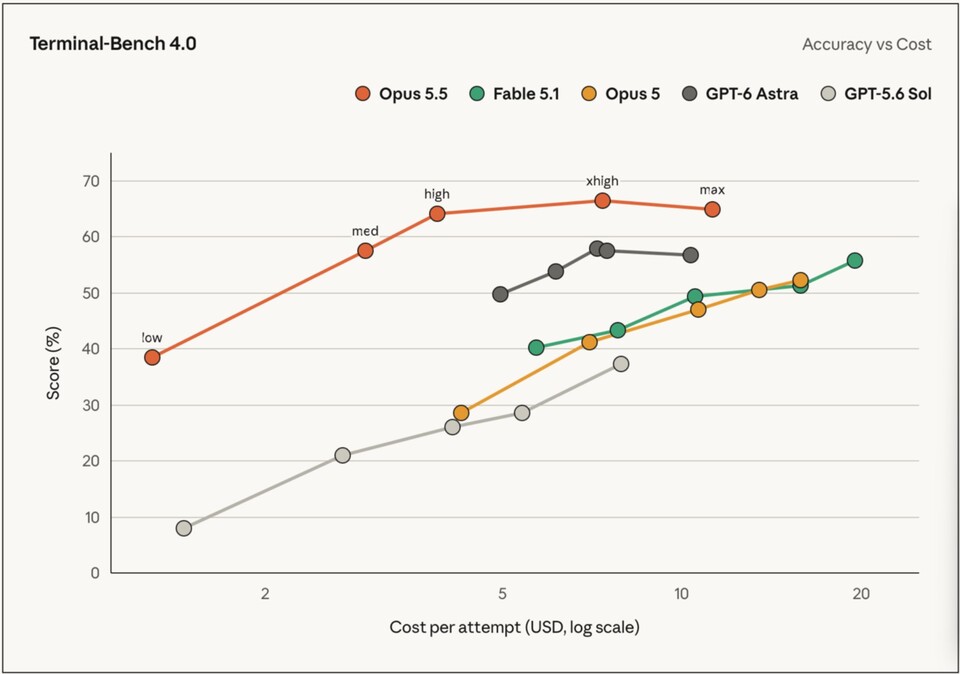
Der Vergleich zwischen Leistung und Kosten verdeutlicht, worauf Anthropic abzielt. Bei GDPval-AA v2.1, einem Test für professionelle Arbeitsabläufe, beziffert das Unternehmen das Ergebnis von Opus 5.5 auf 1.846 Elo-Punkte – deutlich vor Fable 5.1 (1.735 Punkte) und Opus 5 (1.708 Punkte). Bei mittlerem Rechenaufwand übertrifft das neue Modell in diesem Test laut Anthropic sogar GPT-6 Astra unter Maximallast, und das bei etwa einem Fünftel der Kosten pro Aufgabe. Diese Ergebnisse beruhen allerdings auf den internen Messungen des Herstellers.
 Continue reading on original source ↗
