// MACITYNET — INTELLIGENZA ARTIFICIALE
Parli due lingue nella stessa frase? Apple studia come riconoscerle
Questo sito contiene link di affiliazione per cui può essere compensato
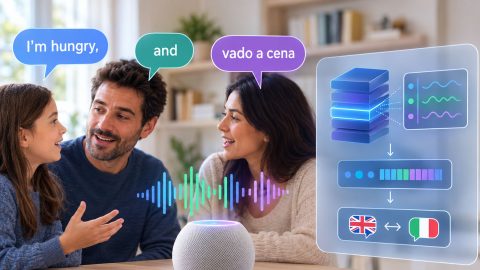
Passare dall’italiano all’inglese nella stessa frase è normale per molte persone che vivono o lavorano in un ambiente bilingue. Per un assistente vocale, questi cambi possono rendere più difficile riconoscere le parole. Una ricerca Apple affronta il problema a partire dai dati: individuare registrazioni in cui si alternano due lingue, senza doverle prima trascrivere, per raccogliere esempi utili all’addestramento dei modelli vocali.
Il fenomeno si chiama code-switching. Può capitare, per esempio, quando un familiare inizia una domanda in italiano e la conclude in inglese. Registrazioni di questo tipo aiutano a rappresentare il modo in cui le persone parlano nella vita quotidiana, ma trovarle in grandi raccolte audio richiede tempo e risorse.
Apple studia quindi un filtro capace di selezionare i brani potenzialmente utili prima di sottoporli ad analisi più costose. La ricerca riguarda la preparazione dei dati: non introduce una nuova funzione già utilizzabile su iPhone o HomePod.
Il sistema sfrutta modelli vocali già addestrati. Al loro interno, l’encoder trasforma l’audio in una rappresentazione numerica: alcune componenti di questa rappresentazione reagiscono diversamente a seconda della lingua ascoltata. Osservandole in brevi intervalli, il rilevatore cerca indizi della presenza di entrambe le lingue nella stessa registrazione.
Per scegliere le componenti da osservare bastano esempi monolingui. Serve però anche un piccolo insieme di registrazioni etichettate con cambi di lingua per regolare la decisione finale. Il sistema può così segnalare i candidati da controllare, evitando di produrre subito una trascrizione di ogni file.
La soluzione basata su Whisper-small di OpenAI osserva otto componenti su 768 di uno strato dell’encoder, circa l’1%. Il dato descrive la quantità di informazioni utilizzata dal rilevatore: non significa che l’intera elaborazione richieda soltanto l’1% del modello o della potenza di calcolo.
Il lavoro, Code-Switching Detection via Language-Selective Dimensions in Speech Foundation Models, è presentato sul sito Apple Machine Learning Research, il portale Apple dedicato all’apprendimento automatico. Firmato da Jie Chi, Zakaria Aldeneh, Masha Fedzechkina, Maureen de Seyssel e Natalie Schluter, è stato depositato su arXiv il 13 ottobre 2026 e aggiornato il 14 ottobre.
I ricercatori hanno valutato il metodo su 14 coppie linguistiche con l’inglese. Per italiano–inglese, Whisper-small raggiunge 0,779 di F1 nella prova con impostazioni ottimizzate sul campione di valutazione. F1 combina precisione delle segnalazioni e capacità di trovare i casi pertinenti: non indica la percentuale di frasi comprese correttamente da un assistente.
Il valore medio di 0,798, citato nella presentazione dello studio, scende a 0,784 quando la calibrazione usa dati separati dalla valutazione. Sul parlato conversazionale, inoltre, il metodo non supera tutti i sistemi di confronto. I risultati mostrano una possibile utilità nella selezione dei dati, con prestazioni che dipendono dalle lingue e dal tipo di registrazione.