// FRANDROID — INTELLIGENZA ARTIFICIALE
QUELLE IA : on a lancé un comparateur gratuit de 252 modèles pour trouver le bon selon votre usage
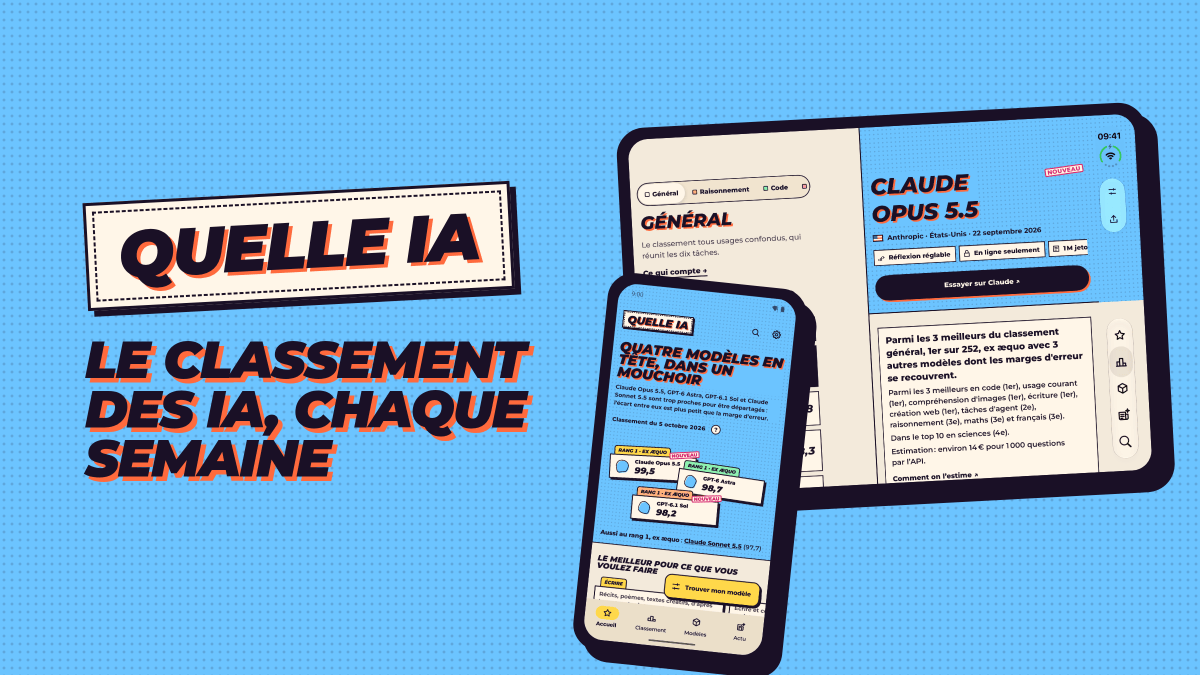
Chaque fois qu’un proche me demande quelle IA adopter au quotidien, je finis par lui répondre par une salve de questions qui agace tout le monde. Est-ce pour coder ou pour rédiger un e-mail ? En version gratuite ou payante ? Directement dans le navigateur ou installé sur un ordinateur ?
En 2026, un nouveau modèle sort presque chaque semaine, systématiquement accompagné de graphiques maison sur lesquels il écrase la concurrence.
Nous avons donc fini par construire l’outil que nous aurions aimé envoyer à la place de ces réponses à tiroirs. Comme c’est notre bébé, conçu par l’auteur de ces lignes et édité par Humanoid (le groupe derrière Frandroid, Numerama et Clubic), autant lire la suite avec le sourcil sceptique que l’on lève d’habitude devant un communiqué de presse.
Concrètement, QUELLE IA évalue 252 modèles de langage (dans son édition du 19 octobre), en croisant 59 grilles de tests (les fameux benchmarks, sur 98 suivis au total), soit plus de 12 000 mesures vérifiables.
Le site ne fait passer aucun benchmark lui-même : il agrège les résultats publiés par des références indépendantes comme Epoch AI, Arena, compar:IA (le comparateur public français), EuroEval ou encore Artificial Analysis, avec l’accord de ce dernier.
Pour que vous puissiez mesurer les progrès accomplis dans le temps, l’échelle est fixée une fois pour toutes, avec une base 100 attribuée au meilleur modèle lors du lancement du site et un score de 50 pour le GPT-4o de fin 2024. C’est ce qui explique que certains scores, tâche par tâche, dépassent déjà les 100 points.
Autour de ce classement général gravitent des palmarès par usage, 78 générateurs d’images, 38 de vidéo, des synthèses vocales jugées sur le français, mais aussi 77 configurations matérielles réelles suivies (cartes graphiques, Mac, PC portables et mini-PC) et 111 applications accompagnées de leurs liens de téléchargement officiels.
La vraie nouveauté méthodologique tient dans l’intégration d’une marge d’erreur statistique.
Chaque score est calculé avec un intervalle de confiance à 90 % : lorsque les fourchettes de deux modèles se chevauchent, l’écart entre eux est trop faible pour être établi avec certitude, et le site les déclare ex æquo au lieu d’inventer un vainqueur artificiel. Cette semaine, Claude Opus 5.5 (99,4), GPT-6 Astra (98,8), GPT-6.1 Sol (98,3) et Gemini 4 Argon (97,3) se partagent ainsi la première marche du podium.
Si ce résultat groupé peut sembler frustrant quand on cherche un nom unique, il reste bien plus honnête que les palmarès habituels qui sacrent un champion à trois dixièmes près. Le face-à-face entre les deux premiers le prouve d’ailleurs visuellement, tant leurs profils de compétences se superposent.