// FRANDROID — INTELLIGENZA ARTIFICIALE
Jev : un cofondateur de ChatGPT lance une IA qui répond en 100 ms, là où GPT met plusieurs secondes
En informatique, un sujet revient tout le temps : la latence. C’est le temps qui s’écoule entre le moment où on envoie une demande et celui où la réponse complète arrive. Sur un chatbot, c’est la petite attente avant que le texte commence à défiler. Trois secondes, ça paraît rien quand on discute. Dans un logiciel qui doit prendre des milliers de décisions par minute, c’est une éternité.
Aujourd’hui, quand un programme a besoin d’une IA pour trancher, il pose sa question à un chatbot et lui demande de répondre dans un format que le code peut lire, souvent du JSON, une sorte de fiche à cases. Puis on croise les doigts pour que le modèle n’invente pas une case, et on attend. Diogo Almeida a passé quatre ans avec ce problème en tête. Sa réponse s’appelle Jev.
TypeSafe AI, fondée en 2024 à San Francisco, a levé 40 millions de dollars en amorçage auprès de DCVC. Elle présente Jev comme le premier « System One Model ». Le nom vient du psychologue Daniel Kahneman, qui distingue le système 1, la pensée rapide et intuitive, du système 2, la réflexion lente et posée. Les chatbots actuels jouent le système 2. Jev veut jouer le système 1 : réagir vite, sans expliquer.
Le principe est simple. On envoie à Jev une situation brute, un e-mail, un ticket de support, une ligne de log, avec une liste de questions fermées : est-ce un spam, ce client va-t-il partir, faut-il alerter quelqu’un ? Il renvoie une réponse pour chaque question, accompagnée d’une probabilité. Un modèle classique écrit sa réponse mot après mot, chaque mot dépendant du précédent. Jev calcule toutes ses réponses d’un coup, en parallèle. C’est ce qui le rend rapide.
Protégez votre vie numérique et vos appareils contre les virus, arnaques, ransomwares et menaces en ligne avec Bitdefender, primé pour sa protection et compatible avec Windows, Mac, Android et iOS.
Temps de réponse annoncé : entre 70 et 500 millisecondes, contre plusieurs secondes pour un grand modèle en mode raisonnement. Les temps de réponse ont été mesurés depuis la côte Ouest des États-Unis, où le service est hébergé. Un développeur, disons à Nantes, ajoutera le ping transatlantique.
Le prix suit la même logique. Les modèles d’IA se facturent au token, un petit morceau de texte d’environ trois quarts de mot. Jev coûte 0,042 dollar le million de tokens envoyés, soit 42 dollars le milliard, et rien pour ce qu’il renvoie. Les grands modèles facturent l’entrée entre 0,20 et 10 dollars le million, et la sortie encore plus cher.
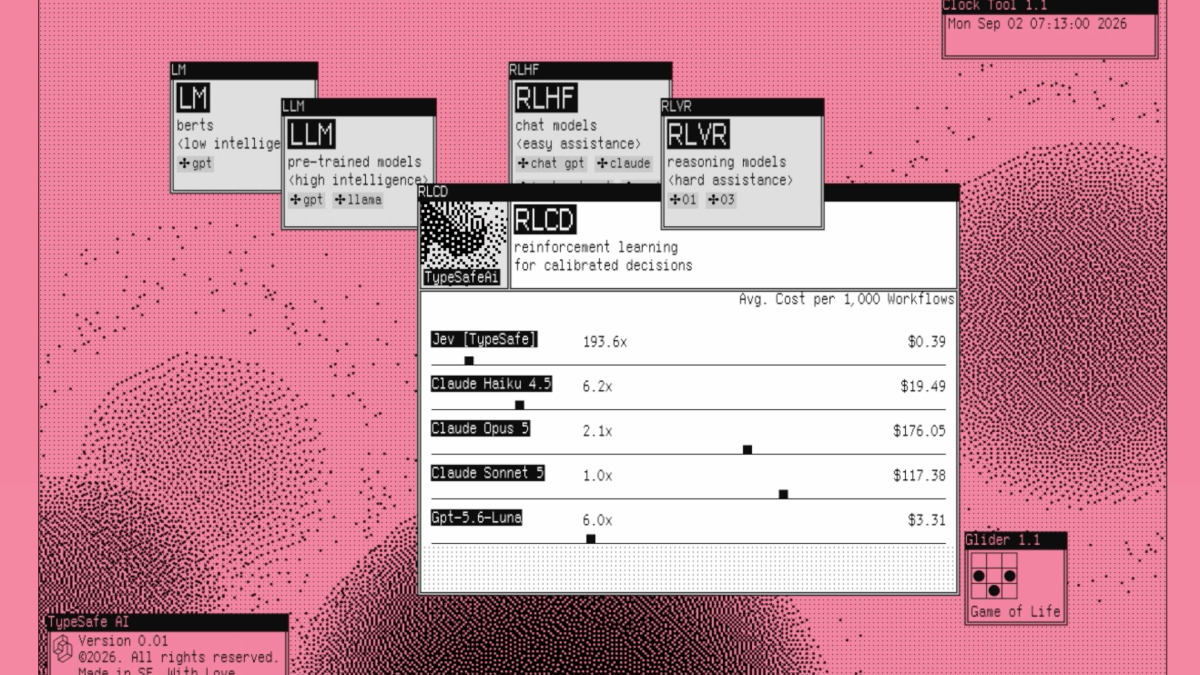
Ce sont des tarifs qu’on ne voit d’habitude que sur des modèles minuscules et peu doués. Pour se faire une idée, voici la comparaison avec les modèles frontières actuels :
Les « 193,6 fois plus rapide » et « 444,6 fois moins cher » affichés sur le site sortent d’un banc d’essai maison. TypeSafe a construit quatre exercices, des enchaînements de décisions comme en ferait un vrai logiciel, et fait passer tous les modèles dessus. Pour savoir qui a raison, la société prend comme référence la moyenne des réponses de GPT-6 Astra et de Claude Fable 5.1. Elle reconnaît elle-même que ça avantage les modèles d’OpenAI et d’Anthropic.
Sur ce graphique, Jev tombe d’accord avec la référence dans 68 % des cas. C’est le niveau de GPT-5.6 Terra, mais moins bien que Sol et Opus 5, autour de 73 à 74 %. Autrement dit, Jev ne prétend pas être plus intelligent. Il prétend faire aussi bien qu’un bon modèle intermédiaire pour cent fois moins cher.