// FRANDROID — INTELLIGENZA ARTIFICIALE
Microsoft dévoile l’intelligence hybride sur Windows : des IA sur PC qui fonctionnent sans Internet
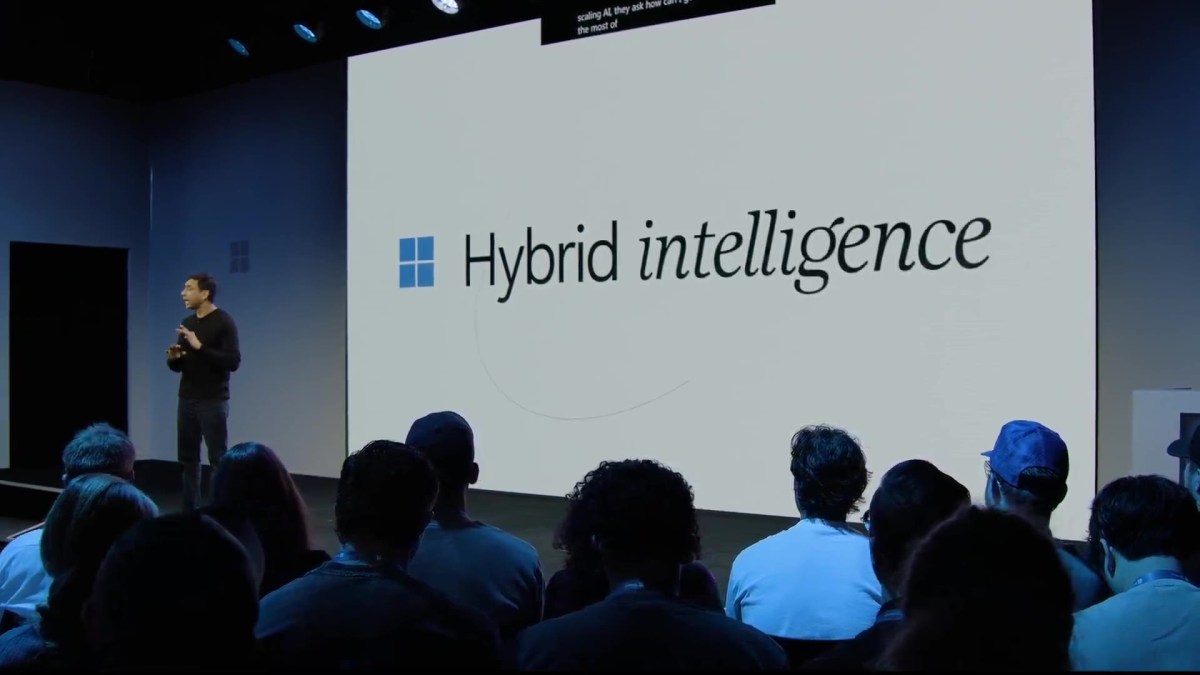
Microsoft veut faire tourner de gros modèles d’IA directement sur les PC Windows, et l’a montré ce mercredi 7 octobre, lors de son événement Windows et Surface, largement consacré aux agents IA.
Trois modèles sont au programme : MAI Code 1.1 Flash, le modèle de code maison, un nouveau Nemotron conçu par Nvidia, et DeepSeek V4 Flash, le plus imposant du lot. L’intérêt est très concret : les données ne quittent pas l’ordinateur, on peut travailler sans connexion, et chaque requête ne grignote plus un quota de jetons (les tokens, ces morceaux de texte que facturent les API et les abonnements).
Microsoft appelle ça « l’intelligence hybride ». Le modèle local traite ce qu’il peut, et le système bascule vers le cloud (GPT, Claude, Gemini, etc.) quand la tâche l’exige. Selon l’entreprise, ses clients veulent surtout tirer le meilleur parti de leurs budgets de jetons sans renoncer aux modèles les plus performants.
MAI Code 1.1 Flash, disponible dans GitHub Copilot depuis le 11 août, compte 130 milliards de paramètres (C’est un mélange d’experts dont 6,8 milliards sont actifs à chaque jeton). Ces paramètres sont les réglages internes appris par le modèle, et leur nombre donne une idée de sa taille. Microsoft l’a quantifié en 3 bits, c’est-à-dire qu’il stocke chacun de ces réglages avec beaucoup moins de précision qu’à l’origine.
Sa taille baisse ainsi de près de 80 % « tout en préservant la qualité du code », selon la marque. Microsoft annonce en local une fenêtre de contexte de 256 000 jetons, soit la quantité de texte ou de code qu’il peut garder en tête d’un seul coup.
Côté Nvidia, le nouveau Nemotron, attendu le 15 octobre, dépasse les 70 milliards de paramètres. Quantifié en 2 bits, il occupe un peu plus de 20 Go de mémoire. Microsoft le destine aux machines équipées de la puce RTX Spark de Nvidia, comme le mini Surface pensé pour l’IA en local.
DeepSeek V4 Flash est le plus gros des trois, avec 284 milliards de paramètres. Quantifié en 1,6 bit, il tient dans 60 Go de mémoire. D’après Microsoft, il dépasse GPT-5, sorti en août 2025 et remplacé depuis par la gamme GPT-6, sur les tests de codage et de raisonnement, un niveau qui était encore réservé il y a un an aux modèles les plus avancés, hébergés dans le cloud.
Le modèle reste utilisable à cette taille parce qu’il s’agit d’un mélange d’experts (MoE) : sur ses 284 milliards de paramètres, seuls 13 milliards travaillent à chaque jeton généré, ce qui allège le calcul mais pas la mémoire. Ses poids sont publics et on peut déjà le faire tourner en local, mais sa version quantifiée en 3 bits pèse 103 Go et réclame une machine dotée de 110 Go de mémoire, selon Unsloth, qui distribue ces fichiers. La compression de Microsoft retire donc encore environ 40 % à ce poids.
Pour autant, la comparaison avec GPT-5 vient de tests maison, qu’il faudra confronter à des évaluations indépendantes. Une compression aussi poussée se paie en général sur la qualité des réponses. Enfin, 60 Go de mémoire libre restent rares sur un PC, alors que Microsoft juge désormais 8 Go de RAM suffisants pour le grand public.
Les machines visées sont donc surtout les PC équipés de la puce RTX Spark de Nvidia, qui peut embarquer jusqu’à 128 Go de mémoire unifiée, partagée entre processeur et carte graphique. Le Surface RTX Spark Dev Box, le mini PC de Microsoft pensé pour l’IA en local, en est doté, avec jusqu’à un pétaflop de calcul IA annoncé par la marque.