// COMPUTERBASE — HARDWARE & GADGET
Google: TPU 8tx schützt sensible Daten, 8i Max skaliert den Speicher
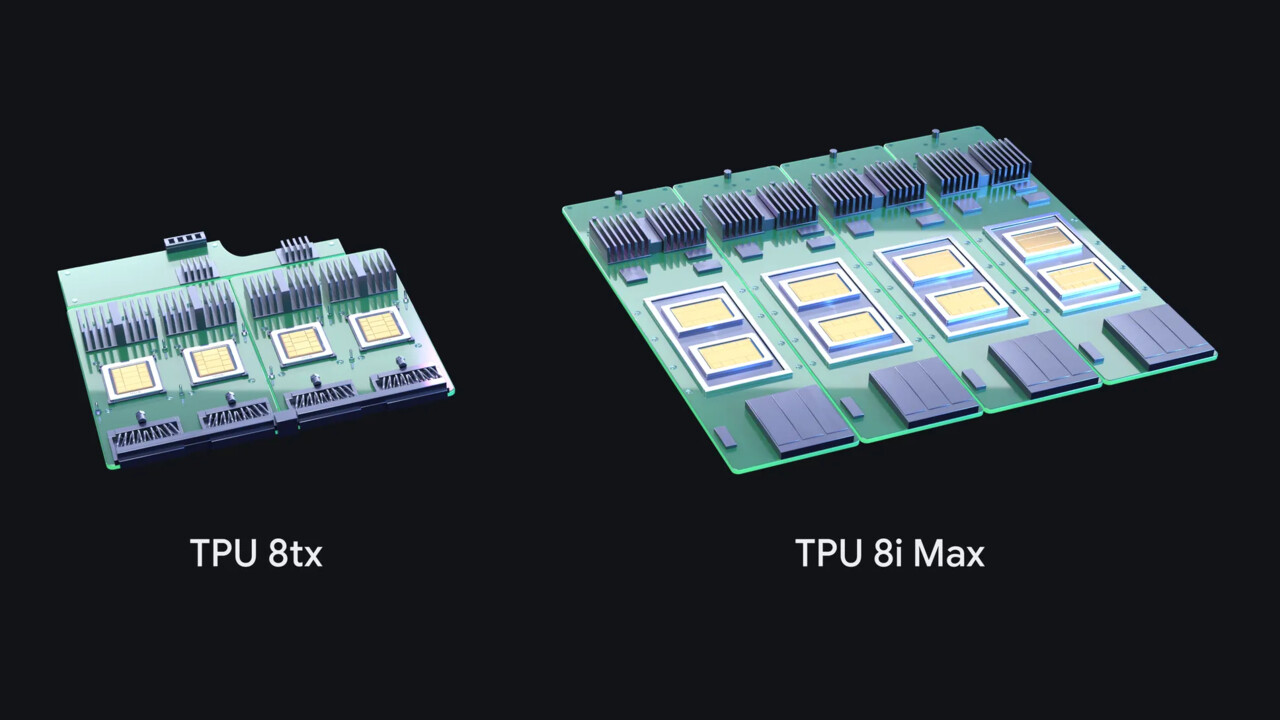
Mit TPU 8tx und TPU 8i Max erweitert Google die achte TPU-Generation um zwei Systeme für unterschiedliche Engpässe: vertrauliche Berechnungen und speicherintensive KI-Agenten. Die neuen Varianten beruhen auf vorhandenen Chips, ändern aber deren Kombination, Vernetzung und Schutzfunktionen. Dazu kommen neue Software-Werkzeuge.
Googles Ankündigung stellt beide TPUs als neue Konfigurationen auf Basis bereits vorgestellter TPU-Siliziumvarianten vor. Damit wächst die Generation auf vier Systeme: 8t, 8i, 8tx und 8i Max. Google hebt als Leitidee den modularen Aufbau hervor: Gehäuse, Speicher, Vernetzung und Sicherheitsfunktionen sollen sich an neue Anforderungen anpassen lassen, ohne jedes Mal einen vollständig neuen Chip zu entwickeln.
TPU 8tx verbindet TPU-8t-Silizium mit speziell angepassten AMD-CPU-Hosts. In einer eigenen Ankündigung erklärt AMD, dass es sich um Epyc-Prozessoren der 5. Generation (Turin) handelt. Das System ergänzt die Hardware um Confidential Computing: Daten und Modellgewichte sollen während ihrer Verarbeitung geschützt bleiben. Damit erweitert Google den Schutz über verschlüsselte Speicherung und Übertragung hinaus auf laufende Berechnungen. Das zielt auf Unternehmen und Behörden, die Modelle oder autonome Agenten mit sensiblen Informationen einsetzen.
Die Vernetzung übernimmt 8tx Boardfly, Googles für TPU 8i entwickelte Netzwerk-Topologie für KI-Inferenz-Chips. Laut Google erreicht das System die bis zu doppelte Leistung von TPU 8t; der zusätzliche Schutz soll nahezu keinen Verlust verursachen. Die Konfiguration ist auf Inferenz ausgelegt, unterstützt aber auch kleinere Trainingsaufgaben. Dazu zählt Google privates Fine-Tuning, Modelldestillation und Reinforcement Learning. Unternehmen könnten so unterschiedliche Arbeitsschritte mit vertraulichen Daten auf einem System ausführen, statt sie zwischen getrennten Clustern zu verschieben.
TPU 8i Max richtet sich an Anwendungen mit großen Kontexten und hohem Speicherbedarf, etwa Agenten, die umfangreiche Codebasen oder lange Videos verarbeiten. Google kombiniert dafür zwei TPU-8i-Chips in einem Paket. Nach Herstellerangaben verdoppelt das gegenüber TPU 8i die Rechenleistung, den SRAM und die Speicherbandbreite des High Bandwidth Memory (HBM). Zugleich soll sich doppelt so viel Silizium im bestehenden Rack-Fußabdruck unterbringen lassen, was die Rechendichte erhöht.
Für TPU 8i nennt Google 384 MB On-Chip-SRAM, 288 GB HBM und eine HBM-Bandbreite von 8.601 GB/s. Weil 8i Max diese Werte laut Ankündigung verdoppelt, lässt sich daraus ein SRAM von 768 MB und eine HBM-Bandbreite von 17.202 GB/s ableiten. Google nennt in der Ankündigung jedoch keine Werte oder absolute HBM-Kapazität für 8i Max.
Die Hardware-Erweiterung wird von Software für Entwicklung, Inferenz und Clusterbetrieb begleitet. TorchTPU ermöglicht native Ausführung von PyTorch; TPU-Backends für vLLM und SGLang sollen bestehende Serving-Umgebungen unterstützen. Googles TPU-Agent-Suite ist in einer Vorschau verfügbar und bindet Claude Code, Cursor sowie Google Antigravity ein. Sie soll beim Einstieg, bei der Leistungsanalyse und beim Abstimmen eigener Kernel helfen. Die Open-Source-Komponente XLA Serving Engine bietet ein C++-Laufzeitsystem für latenzarmes Serving auf TPUs, GPUs und CPUs.
Agent Compute Engine soll inaktive Agentensitzungen anhalten und deren Arbeitsspeicher innerhalb von Millisekunden vom Beschleuniger auslagern. Das adressiert Wartezeiten auf Werkzeuge, Datenbanken oder menschliche Eingaben, während der Agent sonst Rechenressourcen belegen könnte. TPU Sync organisiert den Datentransport zwischen HBM, Host-DRAM, gemeinsamem Speicher und Netzwerk. Dazu gehören KV-Caches, also gespeicherte Attention-Zustände, der Kontexttransfer zwischen getrennten Prefill- und Decode-Knoten sowie die Synchronisierung von Modellgewichten für Reinforcement Learning. Google gibt an, die Latenz beim KV-Transfer und die Zeit bis zum ersten Token um mehr als 90 Prozent zu