// CLUBIC — INTELLIGENZA ARTIFICIALE
Curiosité chez Google, qui sort deux nouveaux TPU pour les agents IA sans dessiner la moindre nouvelle puce
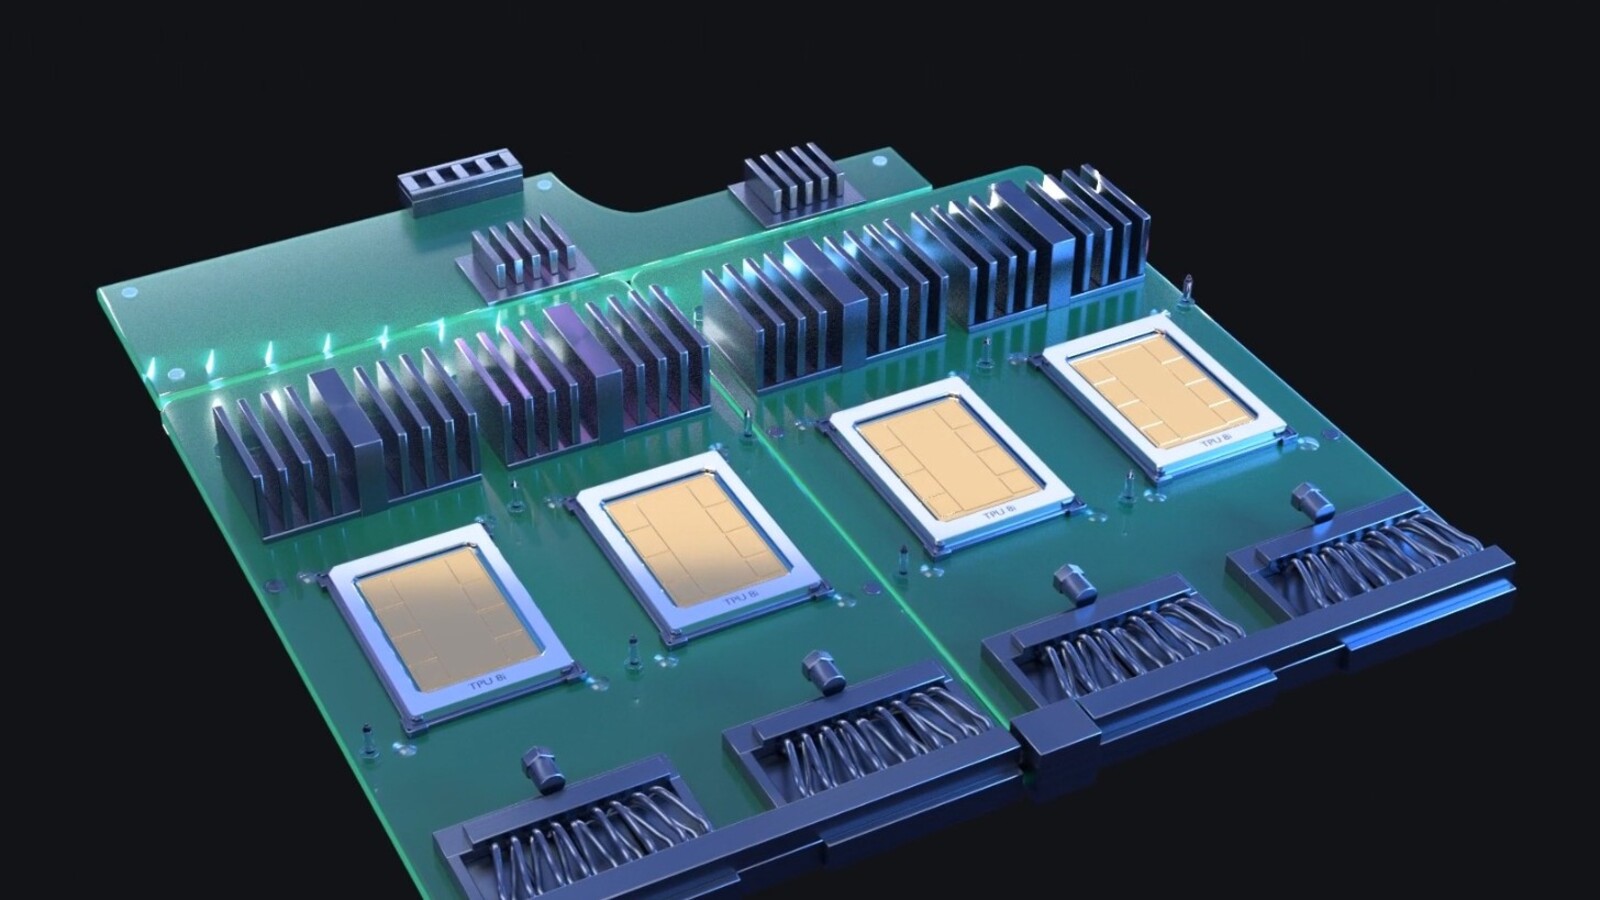
Google complète sa huitième génération de puces IA avec les TPU 8tx et TPU 8i Max, dévoilés lundi. Ces deux systèmes, bâtis à partir de puces existantes, visent la protection des données sensibles et les besoins en mémoire des agents IA.
Après les TPU 8t et 8i en avril, Google étoffe sa gamme de puces IA avec le TPU 8i Max et le TPU 8tx, deux systèmes pensés pour les agents autonomes, autrement dit les IA capables d'enchaîner des tâches sans qu'on leur tienne la main. Alors que les entreprises les mettent au travail, le premier s'attaque à l'embouteillage de mémoire des IA gavées d'informations, tandis que le second protège les données sensibles jusque pendant leur traitement. Et pour cela, aucune nouvelle puce n'a été dessinée, Google ayant confirmé ce lundi 9 novembre avoir réagencé celles dévoilées au printemps.
On rappelle qu'un TPU est une puce, ici conçue par Google avec pour seule obsession ou presque, avaler des calculs d'intelligence artificielle. En dessiner une nouvelle prend plusieurs années, alors l'entreprise retravaille ce qui l'entoure, de l'assemblage au réseau en passant par la mémoire. L'opération prend plusieurs mois, mais elle permet de coller aux demandes des clients. Google aligne ainsi quatre systèmes TPU cette année, une première. Il y a le 8t pour l'entraînement des modèles, le 8i pour le raisonnement en temps réel, et désormais ces deux nouveaux venus, les 8i Max et 8tx.
Lancez des dizaines d'agents sur une base de code entière ou plusieurs heures de vidéo, et vous remarquerez assez vite que la mémoire ne suit plus. Google vise ici des contextes de l'ordre du million de tokens, les petits morceaux d'information qu'une IA doit garder en tête pour travailler. Le TPU 8i Max réunit donc deux puces TPU 8i dans un même boîtier. Que ce soit la puissance de calcul, la capacité de SRAM, la mémoire ultrarapide, et le débit de la HBM, qui alimente la puce en données, tout double par rapport au TPU 8i.
Comme le TPU 8i Max loge deux fois plus de silicium dans une armoire de serveurs de même taille, les data centers peuvent installer nettement plus de puissance au mètre carré et par watt. Côté logiciel, Google traque aussi un gaspillage plus discret, celui des agents qui patientent des secondes ou des heures devant une base de données, un outil externe ou une réponse humaine. Pour limiter la facture pendant ces pauses, son logiciel Agent Compute Engine met automatiquement ces sessions en veille et sort leur mémoire de travail de la puce en quelques millisecondes. L'autre renfort, TPU Sync, dont le code est ouvert à tous, fait fonctionner mémoire de la puce, mémoire du serveur, stockage et réseau comme un seul grand réservoir. Les données de contexte de l'IA y circulent plus vite, et Google promet de réduire de plus de 90 % l'attente avant le début de la réponse.
L'autre nouveauté de Google, le TPU 8tx, reprend le silicium du TPU 8t, conçu pour entraîner les très grands modèles, et l'associe à des processeurs hôtes AMD EPYC de cinquième génération. Il comble une petite carence de l'informatique. Une donnée est habituellement chiffrée, donc illisible, quand elle est stockée ou qu'elle circule sur un réseau, mais elle doit être déverrouillée en mémoire au moment où l'ordinateur la traite. Avec le TPU 8tx, la sécurité est inscrite directement dans le matériel. Les informations sensibles et « poids » du modèle, qui sont des réglages internes qui font sa valeur, restent ainsi protégés et isolés en plein calcul.
Ce TPU s'adresse aux entreprises soumises à de fortes contraintes réglementaires et aux gouvernements, qui veulent faire tourner des modèles d'IA et des agents aux côtés de leurs données les plus sensibles. Pour que ces agents ne restent pas bloqués entre deux étapes d'une mission, il récupère le réseau Boardfly du TPU 8i, conçu pour réduire la latence dans les échanges. Google annonce une latence jusqu'à deux fois plus faible que sur le TPU 8t, avec une pénalité de performance quasi nulle. Le même système